1. Qu’est-ce que l’architecture?
- Couches et accès: Dans le développement logiciel, l’architecture fait référence à plus que la simple structure ou organisation du code. Elle décrit la chorégraphie de la façon dont différentes couches au sein d’un système interagissent les unes avec les autres et comment l’information circule à travers ces couches. L’architecture émerge lorsqu’on délimite l’accès entre ces couches.
- Principes et Architecture: Bien que l’architecture englobe souvent des principes de conception comme SOLID et adopte divers modèles de conception, ces éléments ne constituent pas en soi une architecture.
Cependant, des principes directeurs et des modèles sont indispensables pour une architecture robuste. Ces modèles ne sont que des outils qui aident à réaliser une vision structurelle plus large. Ils ne forment pas l’architecture en tant que telle.
But de l’architecture? = séparation des préoccupations (separation of concerns)
Pourquoi? Elle rend le système plus extensible, maintenable et plus facile à intégrer pour les nouveaux employés. De plus, si une application suit le principe de séparation des préoccupations, les coûts des itérations (le temps nécessaire pour ajouter une nouvelle fonctionnalité) sont réduits car la base de code est structurée et ses composants sont découplés.
2. Quête d’une architecture
2.1 Architecture de base
On crée un projet vide, on crée quelques répertoires et on structure ses fichiers de cette manière. Pas de bibliothèques, de couches ou de règles bien définies pour la répartition des responsabilités. Juste s’assurer que ça fonctionne. Parfait pour les Proof of Concepts (POC) ou les applications de démonstration.
On peut opter pour une architecture de base si l’on veut lancer un MVP (Minimum Viable Product) le plus rapidement possible et que l’on ne veut pas consacrer de temps et de ressources supplémentaires à l’apprentissage des principes d’autres modèles d’architecture. Choisir toujours la séparation des préoccupations. Ne pas développer de mauvaises habitudes en tant que programmeur; votre code est de l’art, alors faites-en une œuvre d’art.
2.2 Architecture N-Tier
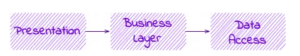
= le fait de diviser son code en couches (tiers), chaque couche gérant un domaine d’intérêt distinct. Le « N » de n-tier indique que l’on peut avoir autant de couches que l’on souhaite (par exemple, 3-tier, 4-tier)
(Note: certains disent que cela signifie Neuropsychopharmacologie.)
Couche de présentation: C’est l’interface utilisée par le client pour communiquer avec votre application (client-facing-layer). Elle peut prendre différentes formes, des applications mobiles ou de bureau à une API ou une ligne de commande.
Par exemple, si vous avez une application distincte pour l’UI, construite avec Angular ou React par exemple, qui communique avec une API backend, alors l’API elle-même sera votre couche de présentation. (Vous traitez l’application Angular comme un client, car c’est une application complètement différente).
- Présentation
- Elle appelle une couche de logique métier (business logic layer), qui assure le traitement des requêtes
- Seules les choses directement liées à la présentation (configurations API, routes, …) se trouvent ici;
- ! Ne laissez pas la logique métier pénétrer dans cette couche! Gardez-la propre des règles de l’entreprise!
- Couche de logique métier (Business Logic Layer – BLL)
- La logique métier de votre application se trouve ici, avec tout sauf l’ORM et autres éléments liés à l’acquisition de données, car ils font partie de votre couche suivante => DAL;
- Comprend : les services utilisés pour la communication avec des systèmes externes, tels que l’envoi d’un e-mail, la diffusion d’un message à un sujet, etc;
- Si la BLL doit stocker, extraire, mettre à jour ou supprimer des données, elle fera appel à la DAL.
- Couche d’accès aux données (Data Access Layer – DAL)
- Théoriquement: elle ne sait rien des autres couches et peut être modifiée à tout moment avec une autre implémentation;
- En raison de la dépendance de la BLL à la DAL, la logique métier sera affectée et les modifications pourront se propager vers le haut, ce qui est un peu étrange car seule l’entreprise devrait pouvoir modifier la BLL;
- La modification du fournisseur de base de données n’est pas déterminée par l’entreprise, c’est une décision infrastructurelle.
Attention aux dépendances : Présentation => BLL => DAL.
Toute notre application dépend de la DAL comme cœur du système (= Database Driven Design). Il ne semble pas vraiment judicieux de rendre cette application dépendante de la DAL.
Partant de l’idée que notre application résout un problème commercial, ne serait-il pas préférable d’élever la BLL et d’en faire le cœur de notre système et de la rendre indépendante des autres couches?
2.3 Architecture hexagonale
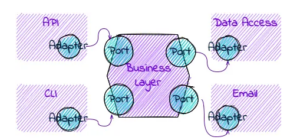
= La BLL est le cœur. Au sein de la BLL, nous définissons des interfaces qui sont implémentées par d’autres composants externes.
Exemple : Les abstractions sont enregistrées dans la BLL (Irepository). Les implémentations sont fournies par les composants (dans ce cas, Data Access).
Dependency Inversion et Dependency Injection nous aident à proposer l’implémentation de Irepository au moment de l’exécution et à éviter ainsi l’appel à DA lors de la compilation. 0 références à d’autres composants de notre application. Elle ne dépend de rien d’autre que de la BL.
Supprimez toutes les autres dépendances des systèmes externes (par exemple : IEmailService, IFileManager, …). Faites abstraction de chaque dépendance d’un autre système en ayant une interface au sein de la BL, et son implémentation comme faisant partie d’un autre composant.
Dans ce contexte, l’interface définie par BL est appelée un Port, et l’implémentation fournie par les autres composants – Adaptateur (c’est pourquoi vous trouverez dans certaines documentations l’architecture hexagonale appelée Ports et Adaptateurs). Adaptateurs primaires (qui appellent la BL) et adaptateurs secondaires (qui sont appelés au moment de l’exécution par la BL, comme DA, E-mail). La couche de présentation du modèle N-tier est représentée par les adaptateurs primaires dans le contexte du modèle hexagonal. Ils agissent comme un contrôleur d’entrée (ingress-controller) et sont des adaptateurs orientés client (API, UI, Ligne de commande). Les adaptateurs secondaires sont ceux qui sont appelés par la BL et qui gèrent la communication avec les systèmes externes.
• Les adaptateurs primaires pilotent – ils font des appels à la BL
• Les adaptateurs secondaires sont pilotés – la BL les appelle en raison du contrôle inversé.
C’est ce que nous appelons un Domain Driven Design (DDD).
Problème: C’est cool, mais avoir des dizaines de composants n’est pas vraiment la meilleure idée. Pourrions-nous trouver un moyen de les regroupe.
2.4 Architecture en oignon
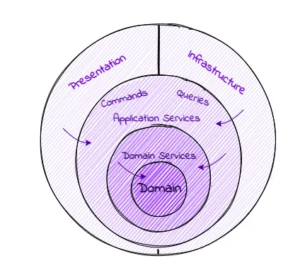
= parce qu’elle imite la structure de l’oignon. Les couches entourent le noyau. Les dépendances vont vers l’intérieur – et des couches externes vers les couches internes. L’idée de la structure en oignon est de placer la logique métier au cœur et de rendre les autres couches dépendantes en utilisant l’inversion de dépendance et l’injection de dépendance.
2 particularités:
- Les adaptateurs primaires (ceux orientés client) font maintenant partie de la couche de présentation, tandis que les adaptateurs secondaires (ceux qui communiquent avec les systèmes externes) font partie de la couche d’infrastructure.
- La logique métier (BL) La logique métier (BL) est maintenant divisée en N couches. N parce que le nombre de couches peut varier selon les cas. Le cœur est représenté par une couche de domaine. Cette couche n’a pas de dépendances et contient des modèles commerciaux, des entités, des objets de valeur, des énumérations et d’autres objets liés à l’entreprise. (Le respect des principes DDD est une bonne pratique pour une bonne conception de la couche de domaine). Les couches intermédiaires peuvent varier. Habituellement, vous placez les services de domaine (un autre concept de DDD) dans une couche distincte autour du domaine, avec quelques ports (interfaces) dont l’implémentation se trouve dans la couche d’infrastructure externe.
(Si vous suiviez CQRS, la commande et la requête pourraient avoir leur propre couche autour des services de domaine.) (Si vous utilisez le modèle de cas d’utilisation, vous le placerez également dans une couche distincte, etc.) Il n’y a pas de règles strictes sur le nombre de couches que vous pouvez avoir.
2.5 Architecture propre
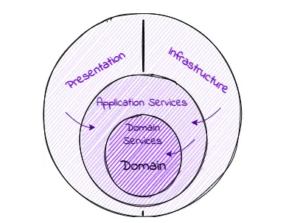
Ajoute un peu de régulation à la structure en oignon. Elle stipule que la couche de domaine est destinée aux règles métier à l’échelle de l’entreprise qui sont les moins susceptibles de changer (entités, énumérations, objets de valeur, objets de domaine de base). Autour de celle-ci se trouve la couche d’application, qui comprend tout ce qui a trait à la façon dont l’entreprise fonctionne. C’est également là que se trouvent les ports (interfaces). La couche d’infrastructure contient des adaptateurs (implémentations) qui servent de passerelles vers les systèmes externes.
Principes clés:
- Règle de dépendance: Les dépendances doivent toujours pointer vers l’intérieur, vers le cœur de la logique métier. Les couches intérieures ne doivent pas dépendre des couches extérieures.
- Séparation des préoccupations: Chaque couche a une responsabilité spécifique et les préoccupations d’une couche ne doivent pas s’infiltrer dans une autre.
Cette séparation aide à maintenir la modularité et la testabilité. - Indépendance des frameworks:: Le cœur de la logique métier ne doit pas dépendre des frameworks ou outils spécifiques. Les frameworks et les outils externes doivent s’adapter à l’application et non l’inverse.
- Peut conduire à un code mieux maintenable, évolutif et testable.
AVANTAGES:
- Modularité et maintenabilité
Avantage: L’architecture propre favorise la modularité en séparant les responsabilités en couches distinctes. Cela rend la base de code plus maintenable et facilite l’application de mises à jour ou de modifications à des composants spécifiques sans affecter l’ensemble de l’application. - Testabilité
Avantage:La séparation des préoccupations facilite les tests unitaires.
La logique métier dans la couche de base peut être testée indépendamment des dépendances externes, ce qui conduit à des tests plus robustes et fiables. - Indépendance des frameworks
Avantage: Le cœur de la logique métier n’est pas étroitement lié à des frameworks ou des bibliothèques spécifiques. Cette indépendance facilite le changement ou la mise à niveau des frameworks sans affecter les fonctionnalités de base. - Flexibilité
Avantage: L’architecture propre offre une flexibilité dans le choix des technologies pour les différentes couches.
Par exemple, vous pouvez passer d’un framework web à un autre, de bases de données ou de frameworks d’UI sans apporter de modifications majeures au cœur de la logique métier. - Évolutivité
Avantage: La structure modulaire de l’architecture propre permet une meilleure évolutivité. Il est plus facile d’adapter différentes parties de l’application indépendamment, et les équipes peuvent travailler sur des couches spécifiques sans gêner les autres.
INCONVÉNIENTS:
- Complexité
Inconvénient: La mise en œuvre de l’architecture propre peut introduire une complexité supplémentaire, en particulier au début du développement. La séparation des responsabilités peut entraîner davantage de fichiers et de dossiers, ce qui peut être accablant pour les petits projets. - Courbe d’apprentissage
Inconvénient: Les développeurs qui découvrent l’architecture propre peuvent être confrontés à une courbe d’apprentissage. La compréhension des principes et la mise en œuvre correcte de l’architecture peuvent prendre du temps et des efforts. - Code passe-partout (boilerplate)
Inconvénient: L’architecture propre peut impliquer l’écriture de plus de code passe-partout, en particulier lors du mappage des données entre les couches. Cela peut entraîner un temps de développement plus long, bien qu’il soit affirmé que les avantages en termes de maintenabilité compensent cet inconvénient. - Sur-ingénierie pour les projets simples
Inconvénient: L’architecture propre peut être excessive pour les projets simples ou de petite taille où les avantages de la séparation des préoccupations et de la modularité ne sont pas aussi évidents. Dans de tels cas, une architecture plus simple est plus appropriée. - Surcharge de performance
Inconvénient: Les couches et abstractions supplémentaires dans l’architecture propre peuvent introduire une certaine surcharge de performance. Dans les applications où la performance est essentielle, des considérations et une optimisation attentives peuvent être nécessaires.
Conclusion:
Avantages en termes de maintenabilité, de testabilité et de flexibilité. Mais il est essentiel de peser ces avantages par rapport aux inconvénients potentiels, en particulier dans le contexte de la portée et de la complexité spécifiques du projet. Ce n’est pas une solution universelle, et les développeurs doivent tenir compte des compromis en fonction des exigences et des contraintes du projet.
L’essentiel:
L’architecture propre n’est pas simplement un autre style d’architecture ; c’est une philosophie, une approche approfondie de la conception de systèmes en donnant la priorité à la maintenabilité et à l’évolutivité. Le cœur de l’architecture propre est formé par les règles métier – immaculées et pures – avec des fonctionnalités externes, telles que les bases de données et l’UI à la périphérie, garantissant que les modifications apportées à un élément n’affectent pas négativement les autres.
L’architecture propre plaide pour une approche guidée par des principes plutôt qu’autoritaire, encourageant les développeurs de logiciels à internaliser son essence pour créer des systèmes résilients à partir de celle-ci.
3. Erreurs courantes et pièges
3.1 Entité: Malentendus et clarifications
Tant Clean Architecture que DDD utilisent le terme « Entité » dans la conception logicielle. Pourtant, elles diffèrent l’une de l’autre. Dans Clean Architecture, les entités encapsulent la logique métier cruciale et sont gardées pures, c’est-à-dire exemptes d’influences externes telles que les bases de données. Dans DDD, les entités soulignent l’importance d’une identité unique dans le contexte limité et sont capables d’encapsuler un comportement plus riche et même des relations complexes avec d’autres entités.
Erreurs courantes et leurs conséquences
De nombreux développeurs, en particulier ceux qui connaissent les frameworks Object-Relation Mapping (ORM), considèrent les entités comme de simples structures de données qui reflètent les enregistrements de la base de données. Cette perception les amène à créer des entités anémiques. Entité anémique: objets qui ne contiennent aucun comportement et servent uniquement de collection de getters et de setters.
Pourquoi est-ce faux?
Réduit la cohésion: Les entités anémiques sont découplées des opérations qui sont effectuées sur elles. En revanche, les entités riches dans l’architecture propre s’efforcent de regrouper les données et les opérations pertinentes, ce qui assure une plus grande cohésion.
Ici, l’opération applyDiscount est découplée de la classe OrderAnemic et placée dans un service. Cela réduit la cohésion car les données (attributs de orderAnemic) et les opérations sur les données (applyDiscount) sont séparées.
Viole l’agnosticisme de la persistance:
Le cœur de la logique métier est implicitement lié à un mécanisme de persistance spécifique en créant des entités qui reflètent directement les structures de la base de données. Cela contraste avec le principe de Clean Architecture qui consiste à séparer la logique de base des détails externes.
L’attribut databaseRowVersion est directement lié à une structure de base de données couramment utilisée pour la concurrence optimiste. En incluant ceci dans notre entité, nous lions l’entité à un mécanisme de persistance spécifique.
Dilue la logique métier: au lieu de centraliser la logique métier au sein des entités elles-mêmes, les entités anémiques diffusent souvent la logique sur les services ou les contrôleurs, ce qui rend le système plus difficile à comprendre et à maintenir.
Jugement de valeur de l’entité:
Il est essentiel de préciser que je ne condamne pas les entités anémiques. Elles trouvent leur place dans des scénarios spécifiques, en particulier dans les applications simplifiées avec une logique de domaine moins complexe ou lorsqu’elles sont combinées avec certains f Si vous choisissez une entité anémique, assurez-vous que c’est parce qu’elle ajoute une valeur tangible à votre scénario, et pas seulement en tant que statue.
3.2 Règles métier de l’application vs Règles métier de l’entreprise
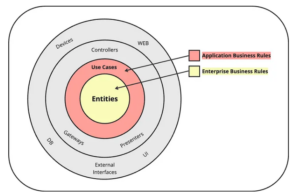
La force fondamentale de l’architecture propre réside dans la délimitation claire des responsabilités, en particulier lorsqu’il s’agit des règles métier de l’application et des règles métier de l’entreprise. Pourtant, les idées fausses courantes brouillent souvent leurs frontières, conduisant à des erreurs de conception. L’architecture propre fait la distinction entre la logique de l’application et la logique métier. La première se concentre sur les conditions spécifiques de l’application, impliquant souvent plusieurs entités ou facteurs externes. La seconde concerne les vérités universelles sur les entités, qui ne sont pas influencées par des circonstances extérieures. Reconnaître ces différences est essentiel pour un système résilient et adaptable.
3.2.1Règles métier de l’entreprise: Cœur de l’entité
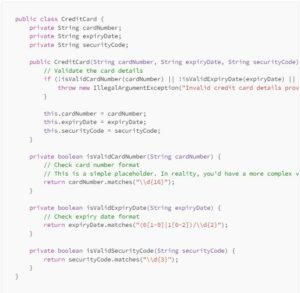
Prenons l’entité « Carte de crédit » en considération. À ce niveau, nous sommes intéressés par les propriétés et les comportements inhérents de la carte de crédit elle-même, quels que soient les facteurs externes ou les conditions spécifiques de l’application. Ici, nous pourrions:
• Valider le format du numéro de carte;
• Vérifier la date d’expiration;
• Vérifier le format du code de sécurité;
Toutes les opérations tournent exclusivement autour de l’entité carte de crédit, l’accent étant mis sur ses propriétés ou comportements intrinsèques. Nous traitons des vérités universelles sur ce qui constitue une carte de crédit valide, sans influence de circonstances extérieures ou de scénarios d’application spécifiques.
3.2.2 Règles métier de l’application (Cas d’utilisation)
Un niveau plus haut, nous trouvons les cas d’utilisation que nos Règles métier de l’application orchestrent. Ici, la logique est guidée par des conditions et des scénarios d’application spécifiques, impliquant souvent plusieurs entités ou facteurs externes.
Avec le même exemple de Carte de crédit, nous pourrions ici:
• Vérifier si l’utilisateur qui demande la carte a au moins 18 ans;
• Déterminer le pays du demandeur et appliquer des règles ou des offres spécifiques à la région;
• Envisager de s’intégrer à des services externes pour effectuer des contrôles de crédit, par exemple.
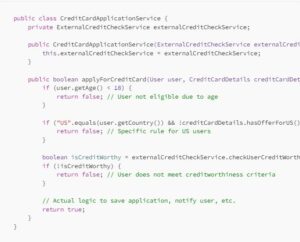
Ici, le service est appelé mais dans une architecture propre, ils parlent généralement (et nomment) des cas d’utilisation.
Cette couche va au-delà des limites d’une seule entité. Elle orchestre les interactions, suit les processus et applique une logique métier contextuelle qui peut être propre à une application ou à un scénario particulier. C’est là que prend vie la logique métier plus large qui est pertinente pour l’application spécifique.
3.3 Erreurs courantes
- Brouiller les frontières: Les développeurs confondent souvent les Règles métier de l’application avec des vérités générales, ce qui éclipse les Règles métier de l’entreprise. Cette idée fausse est aggravée par une fausse idée des entités, qui devraient idéalement être plus en phase avec les faits immuables des Règles métier de l’entreprise.
- Pourquoi est-ce faux:
Ontbreekt aan flexibiliteit: Le fait de traiter les règles métier de l’application comme des vérités constantes entrave la capacité d’adaptation du système aux changements futurs.
Risques pour l’intégrité: Le fait de ne pas distinguer la différence peut entraîner des violations involontaires de la logique métier de base lors de modifications de l’application. - Tout comme notre exemple de code ci-dessus, l’ajout direct du contrôle d’âge de l’utilisateur à la classe carte de crédit serait une erreur. Il s’agirait d’un mélange inapproprié des règles métier de l’application (contrôle d’âge pour la demande d’une carte de crédit) avec les règles de l’entreprise (ce qui rend une carte de crédit valide). Et dans un contexte simple : le modèle CreditCard ne se soucie pas de l’âge de l’utilisateur.
- Pourquoi est-ce faux:
- Entités franchissant les frontières: En raison de la conviction erronée que les entités englobent toutes les règles de l’entreprise, les développeurs peuvent les exécuter directement à partir des contrôleurs, ce qui amène les entités à franchir les frontières qu’elles ne devraient pas.
- Pourquoi est-ce faux:
Violation de la séparation: Le fait d’appeler directement des entités à partir des contrôleurs mine le principe de la séparation des préoccupations.
Violation de la règle de dépendance: Cette approche viole la règle selon laquelle les couches extérieures doivent dépendre des couches intérieures et non l’inverse.
- Pourquoi est-ce faux:
- Mauvaise interprétation du flux de contrôle: Un autre piège consiste à lire les flèches du diagramme d’architecture propre comme des indicateurs de flux de contrôle au lieu de dépendances.
- Pourquoi est-ce faux:
Inversion du flux de contrôle: Bien que les dépendances pointent vers l’intérieur, le flux de contrôle réel va des couches extérieures (comme les contrôleurs) vers l’intérieur et vice versa.
Défauts de conception: Une mauvaise interprétation du flux de contrôle peut conduire à des choix de conception qui compromettent l’adaptabilité et l’évolutivité. - Dans l’approche incorrecte, l’entité est liée à des services externes, ce qui rend le système plus difficile à tester, à comprendre et à maintenir. Elle viole également le principe d’inversion des dépendances, car l’entité de base dépend désormais de détails externes. C’est précisément le type d’erreur de conception que Clean Architecture cherche à éviter.
- Pourquoi est-ce faux:
Vous êtes-vous déjà senti pris au piège dans un réseau de code, ne sachant pas quel fil suivre? Clean Architecture est la boussole qui vous guide hors du labyrinthe. Il ne s’agit pas de la plateforme… il s’agit de la pureté de la conception. Clean architecture n’est pas qu’une méthode, c’est un mouvement. (et il fait appel aux développeurs comme vous qui ont soif de clarté et d’excellence).
Écrit par: Ides VH.